ベクトル検索とは?仕組みからRAG・生成AIでの活用方法まで初心者向けに解説
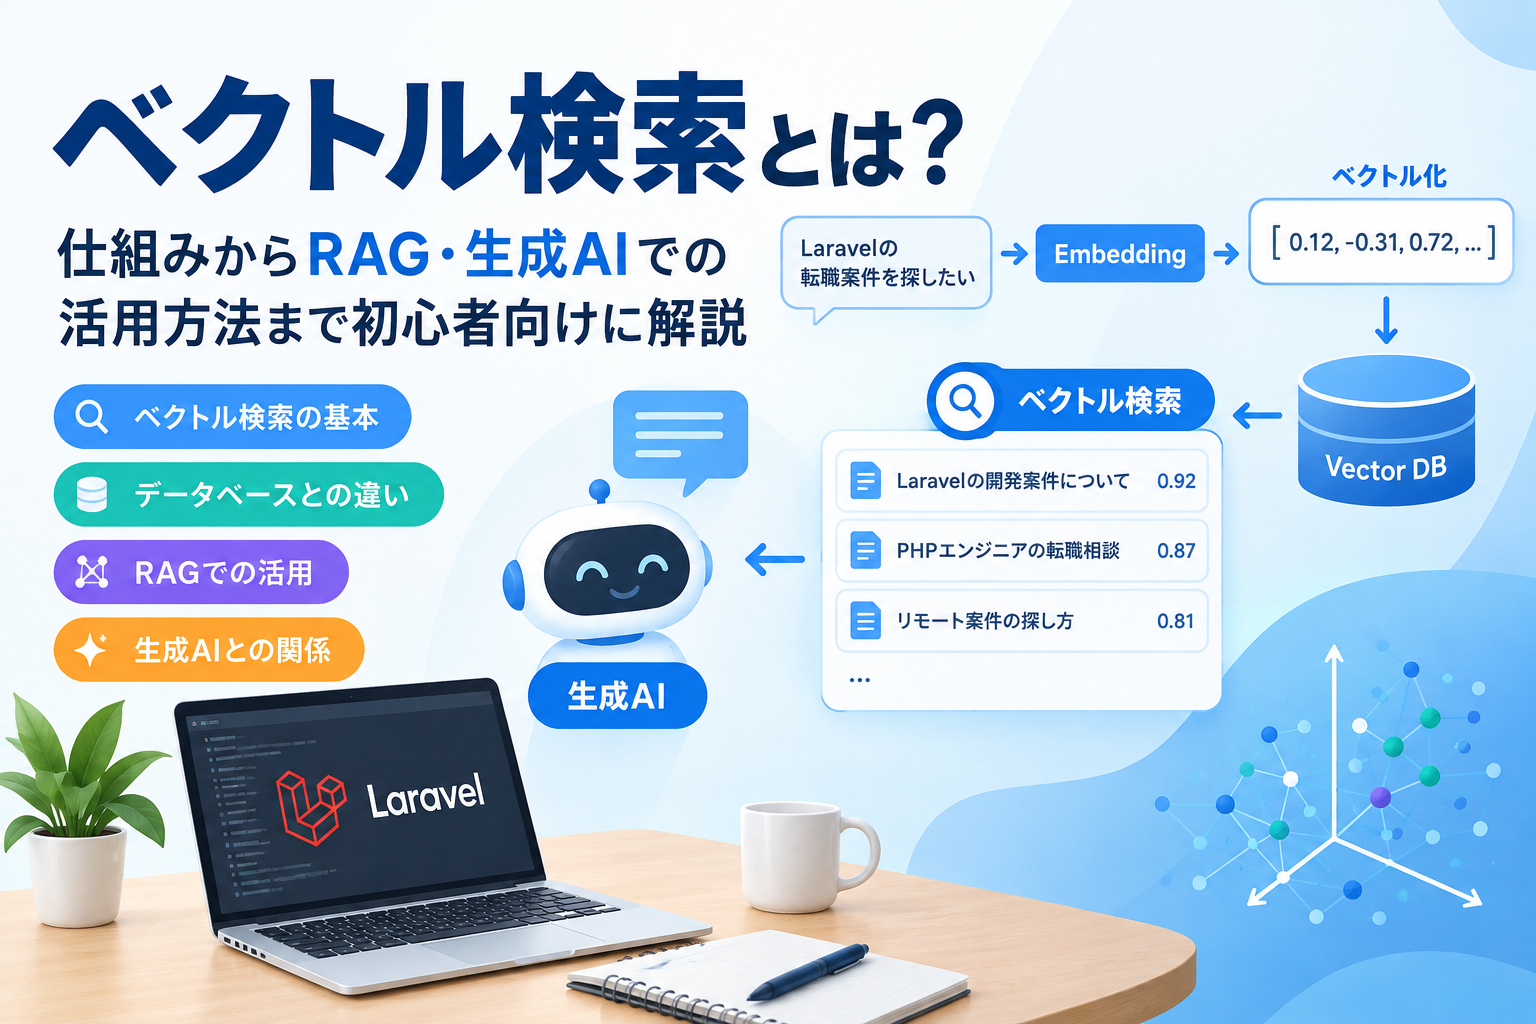
生成AIやRAG(Retrieval-Augmented Generation)について調べていると、「ベクトル検索」という言葉を目にすることが増えてきました。
ベクトル検索は、生成AIが大量の情報の中から「質問に関連する情報」を探し出すための重要な技術です。
従来のデータベース検索では、入力されたキーワードと一致する文字列を探す方法が一般的でした。一方、ベクトル検索では、文章を数値の集合である「ベクトル」に変換し、文章同士の「意味の近さ」を計算して検索します。
この記事では、ベクトル検索の基本的な仕組みから、RAGでどのように利用されるのか、実際のデータベース検索のイメージまで、できるだけ分かりやすく解説します。
ベクトル検索とは?
ベクトル検索とは、文章や画像などのデータを数値化し、その数値の「近さ」を利用して検索する技術です。
例えば、次の3つの文章がデータベースに保存されているとします。
- 「Laravelの開発案件を探しています」
- 「PHPエンジニアとして転職したい」
- 「京都でおすすめのラーメン店を知りたい」
ここで、
「Laravelの仕事を探したい」
と検索したとします。
通常のキーワード検索では、「Laravel」や「仕事」といった文字列が一致する文章を探します。
しかし、ベクトル検索では文章全体の意味を数値化します。
例えばイメージとして、
Laravelの開発案件を探しています
→ [0.12, -0.31, 0.72, 0.18, ...]

PHPエンジニアとして転職したい
→ [0.15, -0.28, 0.69, 0.21, ...]

京都でおすすめのラーメン店を知りたい
→ [-0.73, 0.42, -0.11, 0.81, ...]
のようなベクトルになります。
そして検索した文章についても同じようにベクトル化し、過去のデータとの距離を計算します。
その結果、意味が近い文章ほど上位に表示できます。
つまりベクトル検索は、
「同じ言葉が使われているデータ」を探すのではなく、「意味が近いデータ」を探すための検索技術
と考えると分かりやすいでしょう。
なぜ文章をベクトルにするのか?
コンピューターは、そのままでは文章の「意味」を人間のように理解しているわけではありません。
そこで、文章をEmbedding(埋め込み)という仕組みによって数値の配列に変換します。
例えば、
「LaravelでWebシステムを開発する」という文章をEmbeddingモデルに渡すと、
[0.021, -0.184, 0.563, 0.291, ...]のようなベクトルが返ってきます。
実際にはもっと多くの次元を持つベクトルになります。
重要なのは、個々の数字を人間が読んで意味を判断することではありません。
Embeddingによって、意味的に近い文章がベクトル空間上でも近くなるように表現されることがポイントです。
例えば、
「Laravelの案件を探している」

「PHPのエンジニア求人を探している」
は使われている単語が完全には一致しません。
しかし、意味としてはかなり近い文章です。
ベクトル検索では、このような関係を利用して検索できます。
通常のキーワード検索との違い
一般的なデータベース検索では、例えばSQLのLIKEを使って、
SELECT *
FROM messages
WHERE content LIKE '%Laravel%';
のような検索ができます。
これは「Laravel」という文字が含まれているデータを探す検索です。
一方、ベクトル検索では、
検索文章
↓
Embedding
↓
検索ベクトル
↓
データベースに保存されたベクトルと比較
↓
意味的に近いデータを取得
という流れになります。
例えば、
「Laravelの転職案件を探したい」
という質問に対して、
「PHPエンジニアとして転職先を探しています」
という文章を見つけることができます。
「Laravel」という文字が含まれていなくても、意味が近ければ検索結果に入る可能性があります。
これがベクトル検索の大きな特徴です。
ベクトル検索とRAGの関係
ベクトル検索が特に注目されている理由の一つが、RAGへの活用です。
RAGとは、生成AIが回答を作る前に、外部のデータベースや文書などから関連情報を検索し、その情報をAIに渡す仕組みです。
基本的な流れは、
ユーザー
  ↓
質問
  ↓
Embedding
  ↓
ベクトル検索
  ↓
関連する情報を取得
  ↓
取得した情報+質問
  ↓
生成AI
  ↓
回答
となります。
例えば、社内マニュアルをRAGに登録しておきます。
ユーザーが、
「有給休暇を申請する方法を教えて」
と質問した場合、ベクトル検索によって社内マニュアルの中から、
「休暇申請は社内システムから行います」
といった関連情報を取得します。
そして、その情報を生成AIに渡すことで、登録された社内情報を参考にした回答を生成できます。
ベクトルDBとは?
ベクトル検索を効率的に行うために利用されるのが「Vector Database(ベクトルデータベース)」です。
一般的なデータベースでは、
ID
ユーザーID
文章
作成日時
などのデータを保存します。
ベクトル検索では、これに加えて、
embeddingというベクトル情報を保存します。
例えば、
id: 101
user_id: 10
content: Laravelの開発案件を探しています
embedding: [0.12, -0.31, 0.72, ...]
といったデータです。
代表的な選択肢としては、PostgreSQLのpgvector、Qdrant、Pinecone、Weaviateなどがあります。
既存のシステムに組み込む場合は、必ずしも専用のVector Databaseを使わなければならないわけではありません。
例えばPostgreSQLとpgvectorを組み合わせることで、通常のデータベース機能とベクトル検索を同じ環境で利用できます。
実際のベクトル検索クエリー
例えばPostgreSQLとpgvectorを利用すると、概念的には次のような検索ができます。
SELECT
    id,
    content,
    1 - (embedding <=> :query_embedding) AS similarity
FROM messages
WHERE user_id = :user_id
ORDER BY embedding <=> :query_embedding
LIMIT 5;
ここで、
:query_embeddingには、ユーザーが入力した質問をEmbeddingしたベクトルが入ります。
例えばユーザーが、
「Laravelの転職について相談したい」
と入力した場合、その文章をEmbedding APIなどでベクトル化します。
そのベクトルとデータベースに保存されている過去の文章のベクトルを比較し、距離の近いものを取得します。
さらに、
WHERE user_id = :user_idとすることで、特定のユーザーのデータだけを検索できます。
これは会員制AIチャットなどを作る場合に非常に重要です。
会員ごとのAIにベクトル検索を利用する
例えば会員制のAIチャットサービスを作るとします。
ユーザーAが1年間AIと会話していた場合、数千件、数万件のメッセージがデータベースに蓄積される可能性があります。
すべての会話を毎回AIに送信するのは現実的ではありません。
そこで、
ユーザーAの過去の会話
        ↓
Embedding
        ↓
ベクトルDB
として保存します。
ユーザーAが新しく、
「以前相談したLaravel案件についてもう一度教えて」
と質問した場合、
質問
 ↓
Embedding
 ↓
ユーザーAのデータだけを検索
 ↓
意味の近い過去の会話を取得
 ↓
AIに渡す
 ↓
回答
という仕組みを作れます。
この方法なら、何万件もの会話を毎回AIに渡す必要はありません。
「最近の会話」と「意味的に重要な情報」を組み合わせる
実際のAIサービスでは、ベクトル検索だけに頼る必要はありません。
例えば、
① 現在の会話
② 直近の会話
③ ベクトル検索で取得した過去の会話
④ ユーザーの長期的な情報
を組み合わせてAIに渡す方法があります。
例えば、
【現在の質問】
Laravelの案件について以前相談した内容を教えて

【最近の会話】
現在作っているシステムについての会話

【ベクトル検索結果】
過去にLaravel案件について相談した会話5件

【ユーザー情報】
使用している技術、開発環境など
という情報をAIに渡します。
このようにすると、単純なチャット履歴保存よりも「過去の会話を覚えているAI」に近いシステムを構築できます。
ベクトル検索には限界もある
便利なベクトル検索ですが、万能ではありません。
例えば、
「2025年5月12日の注文番号12345」のような正確なIDや日付を検索する場合、通常のデータベース検索のほうが適しています。
また、ベクトル検索は「意味の近さ」を探す仕組みなので、完全一致が必要な検索には向いていない場合があります。
そのため実際のシステムでは、
キーワード検索+ベクトル検索
を組み合わせる「ハイブリッド検索」が利用されることもあります。
例えば、
キーワード検索
    +
ベクトル検索
    +
ユーザーIDなどの条件
    +
日時などの条件
を組み合わせます。
これによって、意味検索と正確な条件検索の両方を活用できます。
まとめ
ベクトル検索は、文章などのデータを数値化し、「意味の近さ」を利用して検索する技術です。
基本的な流れを整理すると、
文章
 ↓
Embedding
 ↓
ベクトル化
 ↓
Vector DBへ保存
 ↓
質問もベクトル化
 ↓
類似度を計算
 ↓
関連するデータを取得
 ↓
生成AIへ渡す
となります。
特に生成AIのRAGでは重要な技術であり、社内文書検索、FAQ、AIチャットボット、会員ごとのパーソナルAIなど、さまざまな用途に利用できます。
従来の検索が「入力されたキーワードを探す」仕組みだとすれば、ベクトル検索は「入力された質問と意味が近い情報を探す」仕組みです。
生成AIを使ったサービスを開発する場合、単純にAI APIを呼び出すだけでなく、データベース、Embedding、ベクトル検索、RAGを組み合わせることで、ユーザーごとの情報を活用できるAIシステムを構築できます。
今後、生成AIを業務システムやWebサービスに組み込んでいくうえで、ベクトル検索は理解しておきたい重要な技術の一つです。